اجرای تست لیفت
یک تغییر مشخص را میسنجید: بودجهای که در تاریخی بالا بردید، کمپینی که خاموش کردید. لیفت سریِ روزهای بعد را با «همان چیزی که اگر دست نمیزدید اتفاق میافتاد» مقایسه میکند و اثر را با بازه اطمینان ۹۵٪ گزارش میدهد.
لیفت چه چیزی را میسنجد#
هر بار که بودجهای را بالا میبرید یا کمپینی را خاموش میکنید، پرسش بعدی همیشه یکی است: «واقعا فرقی کرد؟» عدد خام دو هفتهٔ بعد جواب نمیدهد، چون فروش شما بههرحال روند و فصل و نوسان روزانه دارد.
لیفت این کار را میکند: از دادههای پیش از تاریخ اقدام یک مدل میسازد، با آن پیشبینی میکند اگر هیچ کاری نمیکردید روزهای بعد چه میشد — این همان ضدواقعیت است — و تفاوت واقعیت با ضدواقعیت را جمع میزند. آن مجموع، لیفت افزایشی است و همیشه با یک بازه اطمینان ۹۵٪ میآید.
واحد کار، یک اقدام است، نه یک کانال. برای دیدن تصویر سبد کانالها در بلندمدت به مدل مارکتینگ میکس بروید؛ آن ابزار حدود دو سال داده میخواهد، لیفت با حدود دو ماه کار میکند.
«تست لیفت (Lift Test)» در پلن رایگان نیست. اگر وبسایت روی پلن رایگان باشد، بهجای صفحه پیامی میبینید که میگوید این یک ویژگی پریمیوم است، با دکمهٔ «ارتقای پلن». مستندات اشتباه نیست — پلن آن وبسایت این ویژگی را ندارد و پلن روی هر وبسایت جداگانه تعیین میشود.
اقدام را تعریف کنید#
آزمونها در مسیر /lift هستند. ساختن یک آزمون یعنی جوابدادن به دو دسته پرسش: چه کاری کردید، و میخواهید اثرش را روی چه چیزی و در چه بازهای ببینید.
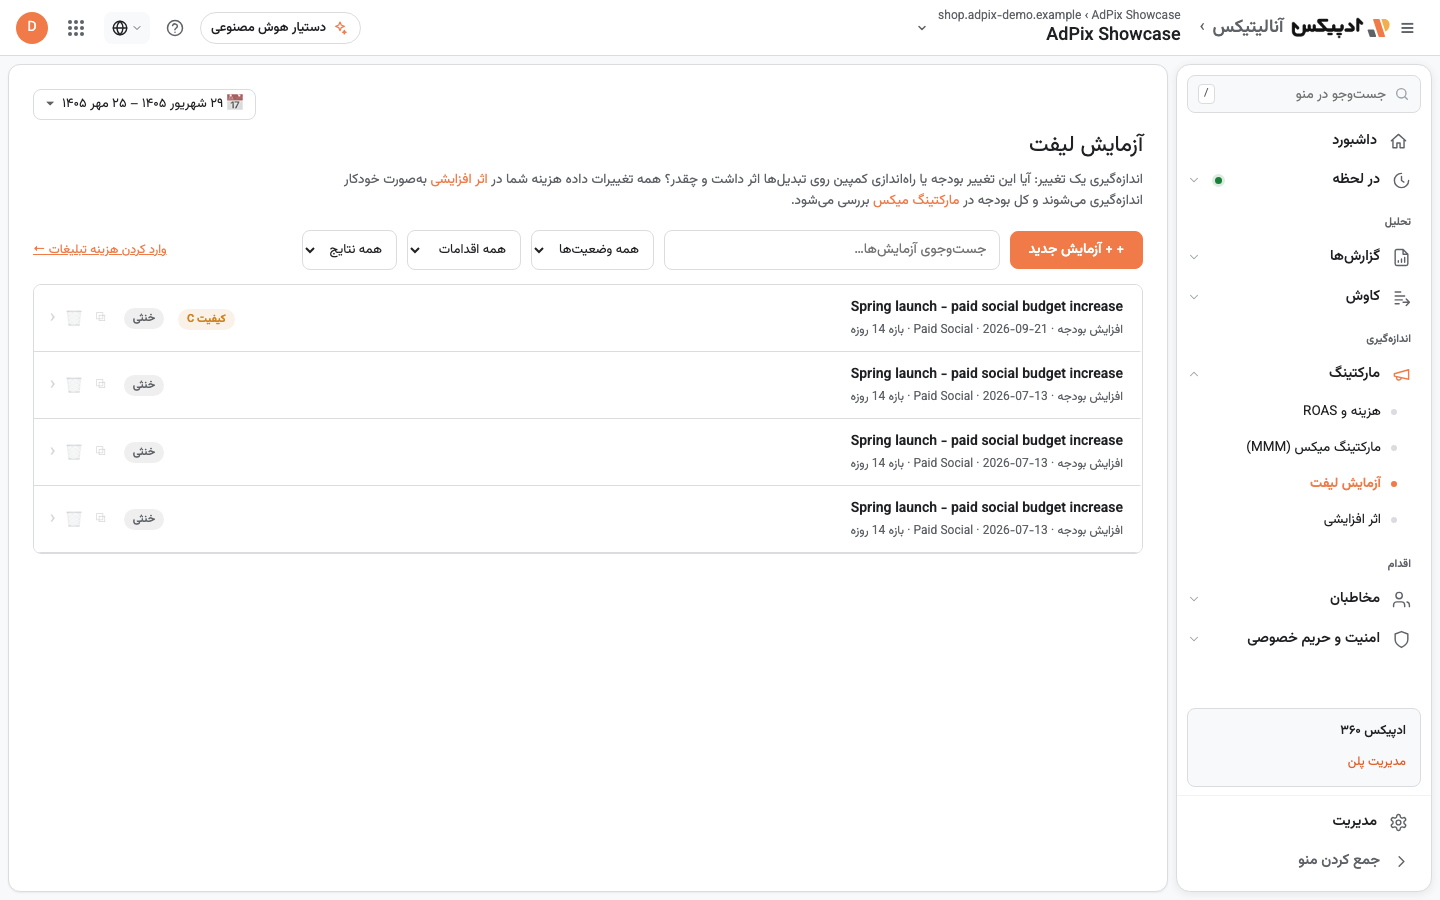
فهرست، هر آزمون را با نام، نوع اقدام، کانال، تاریخ و طول پنجره نشان میدهد و در انتهای ردیف یا وضعیت جاری («زمان بندی شده»، «در صف»، «در حال اجرا»، «ناموفق») یا حکم آزمون تمامشده میآید. آزمونهای در جریان بالای فهرست مینشینند.
فیلدهایی که روی دقت اثر میگذارند#
| فیلد | پیشفرض | چرا مهم است |
|---|---|---|
| «دوره اندازهگیری» | ۱۴ روز | فقط ۷، ۱۴ یا ۲۸ روز پذیرفته میشود. ۱۴ روز دو چرخهٔ کامل هفتگی است و برای بیشتر حجمها انتخاب متعادلی است |
| «دوره پیشین (روزهای تاریخچه)» | ۵۶ روز | خوراک ساخت ضدواقعیت. راهنمای فیلد دستکم ۴۲ روز را توصیه میکند؛ زیر ۱۴ روز اصلا قابل برازش نیست |
| «استفاده از تقاضای ارگانیک به عنوان کنترل» | روشن | حجم نشست ارگانیک و مستقیم را بهعنوان شاخص تقاضا وارد مدل میکند تا موج کلی بازار به حساب اقدام شما نرود |
| «موتور» | «گروهی (سریع)» | موتور پیشفرض سریع است؛ «رویکرد بیزین» کندتر و در بیان عدمقطعیت سختگیرتر است |
اگر به نتایج مشکوکید، آزمونی روی تاریخی بسازید که هیچ اتفاقی در آن نیفتاده. حکم باید «خنثی» بیاید. این همان چیزی است که گیت داخلی محصول هم میسنجد و سادهترین راه اعتمادکردن یا نکردن به بقیهٔ آزمونهاست.
ضدواقعیت چطور ساخته میشود#
موتور پیشفرض («گروهی (سریع)») روی دورهٔ پیشین چند مدل نامزد را برازش میکند — یک مدل ساختاری سری زمانی با سطح گامتصادفی و فصلی هفتگی، و یک مدل «همان روزِ هفتهٔ پیش» — و آنکدام را نگه میدارد که روی دنبالهٔ کنارگذاشتهشدهٔ انتهای دورهٔ پیشین کمترین خطا را داشته باشد. بعد روی کل دورهٔ پیشین دوباره برازش میشود و روزهای بعد از اقدام را پیشبینی میکند.
پهنای بازه از یک بازنمونهگیری بلوکی باقیماندهها میآید: مدل دهها بار روی سریهای ساختگی دوباره برازش میشود تا هم عدمقطعیت خودِ پارامترها و هم نوفهٔ آینده در بازه بنشیند. بلوکهای هفتروزه همبستگی هفتگی را حفظ میکنند.
موتور «رویکرد بیزین» ساختار مشابهی را — سطح گامتصادفی، فصلی هفتگی و رگرسیون روی کنترل — بهصورت بیزی برازش میکند و ضدواقعیت را از توزیع پسین شبیهسازی میکند. کندتر است و وقتی حجم روزانه کم است، بازهاش صادقتر پهن میشود.
هر دو موتور، رویدادهای فصلی تقویم — نوروز، رمضان، محرم و بقیه — را که در پنجرهٔ آزمون بیفتند، بهعنوان کنترل بیرونی میگیرند تا موج تعطیلات به حساب اقدام شما نوشته نشود. تقویم فصلی توضیح میدهد اینها از کجا میآیند.
روش تحلیل کالیبرهشده با آزمون پلاسیبو (v2)#
همه آزمایش های جدید یا دوباره اجراشده با این روش سنجیده میشوند و کلیدی برای خاموش کردن آن وجود ندارد. آزمایش هایی که قبلا تمام شدهاند، با همان روش قبلی خود باقی میمانند.
ایده ساده است: پیش از اعتماد به یک نتیجه، بررسی کنید این روش چند بار اثری را گزارش میکند که وجود ندارد. روش تحلیل همان آزمون را هر هفته روی تاریخ هایی از یک سال گذشته شما تکرار میکند که در آن ها تغییری نداده بودید، و خطای پیش بینی هر بار را ثبت میکند. همین خطاها بازه اطمینان و p-value آزمایش واقعی شما را تعیین میکنند. بالای نتیجه، سطر کالیبراسیون نشان میدهد این خطاها از کجا آمدهاند:
| کالیبراسیون | معنی |
|---|---|
| سابقه همین وبسایت (N آزمون پلاسیبو) | بازه با تاریخ هایی از گذشته همین وبسایت سنجیده شده که در آن روزها تغییری انجام نشده بود |
| داده تجمیعی شبکه | سابقه این وبسایت کافی نیست؛ بازه با خطای آزمون های پلاسیبو در وبسایت های مشابه سنجیده شده است. این داده ناشناس و تجمیعی است |
| فقط مدل | نه در این وبسایت و نه در شبکه سابقه کافی وجود ندارد؛ بازه برآورد خود مدل است و درجه کیفیت حداکثر C میشود |
- برآورد بدون اقدام میانگین پنج مدل پیشبینی است، نه انتخاب یکی از آنها؛ پس وقتی یک مدل خطا میکند، نتیجه پایدارتر میماند.
- هفتههایی با تغییر واقعی هزینه، قطعی یا مناسبتی که در بازه آزمایش شما نیست، از آزمونهای پلاسیبو کنار گذاشته میشوند.
- معنادار بودن هم به p-value حداکثر ۵٪ نیاز دارد و هم به بازهای که صفر را شامل نشود.
- اگر در بازه آزمایش مناسبتی باشد که پیش از آن هرگز دیده نشده (مثلا یک تخفیف فقط در روزهای آزمایش)، اثر آن از اثر تبلیغات جدا نمیشود. کارت اعتبار آزمایش نام آن را میآورد و درجه کیفیت حداکثر C میشود.
- روزهایی که داده آن ها ناقص است (قطعی ردیاب یا روزهای پیش از نصب کد رهگیری) در کارت اعتبار آزمایش با عنوان تعداد روز با داده ناقص شمرده میشوند. اگر یکی از آن ها در بازه آزمایش باشد، قطعی در بازه آزمایش «بله» میشود و درجه کیفیت به C میرسد.
- روزهایی که سنجه به صفر رسید ولی کد رهگیری همچنان بازدیدها را ثبت میکرد (کسبوکار تعطیل بود یا پرداخت از کار افتاد) هم داده ناقص به حساب میآیند و با عنوان روزهایی که سنجه به صفر رسید ولی کد رهگیری فعال بود (احتمال تعطیلی) نمایش داده میشوند. این روزها هرگز اثر تغییر شما شمرده نمیشوند؛ اگر بیشتر بازه آزمایش را بپوشانند، آزمایش سنجیده نمیشود.
- یک استثنا: پس از تغییری که هزینه را کم میکند (توقف کمپین، حذف کانال یا کاهش بودجه)، رسیدن خرید ها به نزدیک صفر ممکن است اثر خود همین کاهش باشد. این روزها در نتیجه میمانند، درجه کیفیت به C میرسد و صفحه هشدار میدهد: «خرید ها پس از این تغییر تقریبا به صفر رسید، در حالی که بقیه ترافیک ادامه داشت. اگر کسب و کار تعطیل بوده است، این اثر تبلیغات نیست.»
- به همین ترتیب، وقتی کل ترافیک وبسایت همزمان با کاهش هزینه تبلیغات افت میکند (فروشگاهی که فروشش از تبلیغات است و همه کمپین ها را متوقف میکند)، این افت اثر همان کاهش شمرده میشود، نه از کار افتادن کد رهگیری. این روزها در نتیجه میمانند، درجه کیفیت به C میرسد و صفحه هشدار میدهد که قطعی کد رهگیری در همان لحظه قابل تشخیص نبود.
کنترلهای برآورد بدون اقدام#
در v2 فیلد کنترلهای برآورد بدون اقدام جای کلید ترافیک ارگانیک را میگیرد:
| گزینه | چه زمانی استفاده کنید |
|---|---|
| فقط عوامل بیرونی (پیشنهادی) | پیشفرض. فقط رویدادهای تقویمی کنترل هستند و ترافیک ارگانیک بهعنوان یک نتیجه سنجیده میشود |
| ترافیک ارگانیک سایت بهعنوان کنترل (ممکن است اثر را کمتر نشان دهد) | رفتار قبلی که برای مقایسه حفظ شده است. تبلیغات هم بازدید ارگانیک را بالا میبرند، پس نتیجه فقط اثر مستقیم است و همین برچسب را میگیرد |
| بدون کنترل | یک پیشبینی ساده قبل و بعد |
کارت ارگانیک سایت (اثر هالهای) اثر اقدام را روی ترافیک ارگانیک و مستقیم گزارش میدهد. مقدار مثبت یعنی اثر هالهای (تبلیغات ترافیک ارگانیک را هم بالا بردهاند)؛ مقدار منفی یعنی همخواری، یعنی کانال پولی تقاضایی را گرفته که بههرحال میآمد.
پیش از آزمایش، حساسیت را بررسی کنید#
در پنل آزمایش جدید، بخش حساسیت آزمایش پیش از هر هزینهای به این پرسش جواب میدهد: «آیا این آزمایش میتواند اثری را که انتظار دارم تشخیص دهد؟» مقدار تغییر برنامهریزیشده هزینه (٪) را وارد کنید و بررسی حساسیت را بزنید. نتیجه شامل این موارد است:
- حداقل اثر قابل تشخیص (MDE) در بازه انتخابشده برای این وبسایت؛
- احتمال تشخیص تغییر برنامهریزیشده، وقتی یک اجرای مدل مارکتینگ میکس این کانال را سنجیده باشد؛
- کوتاهترین بازه از بین ۷، ۱۴ یا ۲۸ روز که به توان آماری ۸۰٪ میرسد، و اندازه تغییر لازم برای آن.
درجه کیفیت و کشف نادرست#
هر نتیجه v2 یک درجه از کیفیت A تا کیفیت D دارد:
| درجه | معنی |
|---|---|
| A | کالیبرهشده، سوگیری کم در آزمونهای پلاسیبو، بازه بدون اختلال و تغییر هزینه قابلتوجه |
| B | کالیبرهشده، با چند مشکل جزئی |
| C | مبتنی بر مدل، یا هزینه پیش از آزمایش تغییر کرده؛ فقط برای تشخیص جهت کلی مفید است |
| D | قابل اتکا نیست؛ هرگز به مدل مارکتینگ میکس فرستاده نمیشود |
کارت اعتبار آزمایش نشان میدهد درجه بر اساس چه مواردی تعیین شده است. در فهرست آزمایشها، علامت ⚠ کنار یک نتیجه معنادار یعنی این نتیجه در بررسی کشف نادرست بین آزمایشهای ۱۸۰ روز اخیر این وبسایت باقی نمیماند. وقتی آزمایشهای زیادی اجرا میکنید، چند مورد ممکن است تصادفی معنادار به نظر برسند.
سایر تغییرات هزینه در اطراف آزمایش#
وقتی تغییرات هزینه این وبسایت ثبت میشوند (سنجش افزایشی (Incrementality) ← فعالیتها)، نتیجه جدول سایر تغییرات هزینه در اطراف این آزمایش را نشان میدهد: تغییرات قابلتوجهی (دستکم ۱۰٪ هزینه روزانه کل) که در طول بازه آزمایش یا در ۱۴ روز پیش از آن انجام شدهاند.
- در طول بازه: لیفت اثر این تغییرات را هم در بر میگیرد، پس آزمایش نمیتواند همه آن را به اقدام شما نسبت دهد. چنین آزمایشی هرگز درجه A نمیگیرد.
- کمی پیش از بازه: خط پایه جابهجا شده است، پس آزمایش دارای اختلال در نظر گرفته میشود.
- اندازهگیریشده در این آزمایش: یک آزمایش خودکار چند تغییر را با هم اندازه میگیرد. هر ردیف سهم آن تغییر از لیفت مشترک و میزانی از این سهم را که دادهها مشخص کردهاند (تعیینشده با داده) نشان میدهد. مقدار کم یعنی تقسیم بیشتر بر اساس برآورد اولیه است.
فعالیت هایی که خودتان ثبت کردهاید (تخفیف، تغییر قیمت، پست اینفلوئنسر و مانند آن) با نوعشان و فارغ از اندازه در این جدول میآیند. تغییری که آن را آزمایش میکنید (همان کانال و کمپین در فاصله ۷ روز) و فعالیت های نادیده گرفته شده هرگز در این جدول نمیآیند.
چرا آزمون «زمان بندی شده» میماند#
اگر پنجرهٔ اندازهگیری هنوز تمام نشده باشد، آزمون بلافاصله اجرا نمیشود و در وضعیت «زمان بندی شده» میماند. اجرا خودکار وقتی شروع میشود که آخرین روز پنجره گذشته باشد، بهعلاوهٔ ۲ روز مهلت برای تبدیلهایی که دیر میرسند (سفارشهای سمت سرور، اسناد تاخیری).
این عمدی است. سنجیدن پنجرهای که هنوز تمام نشده یعنی مقایسهٔ روزهای خالی با ضدواقعیتی که پر است — نتیجهاش یک لیفت منفی جعلی است. لازم نیست کاری کنید؛ آزمون خودش به صف میرود.
نتیجه را بخوانید#
حکم و بازه#
بالای کشوی نتیجه، خلاصهٔ اقدام و در انتهای آن نشان حکم میآید:
| حکم | یعنی چه |
|---|---|
| «مثبت» | کل بازه اطمینان ۹۵٪ لیفت بالای صفر است |
| «منفی» | کل بازه زیر صفر است |
| «ترکیبی» | بازه صفر را رد میکند ولی روزهای مثبت و منفی هر دو زیاد است — اثر یکدست نیست |
| «کاهش · غیرمعنادار» / «افزایش · غیرمعنادار» | بازه صفر را در بر میگیرد، ولی برآورد ۱٪ یا بیشتر تغییر کرده است: نشان جهت تغییر را با رنگ کم رنگ میگوید و جمله زیر آن برآورد، p، بازه ۹۵٪ و «آن را کاهش (افزایش) احتمالی بخوانید، نه اثبات شده» را میآورد |
| «تغییر روشنی ندارد» | بازه صفر را در بر میگیرد و برآورد کمتر از ۱٪ تغییر کرده است |
| «خنثی» | آزمایشی که سنجیده نشد (مثلا به دلیل روزهای نامعتبر زیاد)؛ به جای نتیجه، دلیل آن نمایش داده میشود |
زیر آن، یک جملهٔ فارسی همین را روایت میکند و کنارش «معنادار (p=…)» یا «غیرمعنادار (p=…)» میآید. آن p یک مقدار p دوطرفه است که در سطح ۵٪ (α = ۰٫۰۵) آزمون میشود؛ یعنی همان آزمونی که بازهٔ ۹۵٪ بر آن استوار است. برچسب «معنادار» از حکم پیروی میکند: فقط کنار نتیجهٔ «مثبت» یا «منفی» میآید که بازهٔ ۹۵ درصدیاش صفر را در بر نمیگیرد. نتیجه ای که بازه آن صفر را در بر دارد همیشه «غیرمعنادار» خوانده میشود، حتی اگر p کوچک به نظر برسد؛ چون چنین بازه ای نبود اثر را رد نمیکند. با این حال برآورد آن گفته میشود: نتیجه ای با برآورد ۲۵.۶٪ کاهش «کاهش · غیرمعنادار» نمایش داده میشود، نه «خنثی». اگر توان آزمایش کم باشد، جمله کوچک ترین تغییری را که آزمایش با اطمینان تشخیص میدهد هم میگوید. «MAPE برازش» هم کنارش میآید و کیفیت ضدواقعیت روی دورهٔ پیشین را نشان میدهد: هرچه کمتر، پیشبینی نزدیکتر به رفتار واقعی سایت.
حکم «خنثی» یک نتیجه است، نه شکست#
این مهمترین جملهٔ این صفحه است. «خنثی» یعنی تغییری که دیدید در محدودهٔ نوسان طبیعی همان سری جا میشود. مدل عمدا اثری را که نمیتواند از آن دفاع کند اعلام نمیکند.
ولی هر «خنثی» یک معنا ندارد؛ کارت «قابلیت تشخیص» حالتها را از هم جدا میکند:
| برچسب | حداقل اثر قابل تشخیص | خواندنش |
|---|---|---|
| «اطمینان بالا» | زیر ۵٪ | آزمون توان دیدن اثر کوچک را داشت؛ خنثی یعنی احتمالا اثری نبوده |
| «اطمینان متوسط» | زیر ۱۰٪ | خنثی معنادار است ولی اثرهای ریز از دستش در میرفت |
| «پایین — بازه پهن» | زیر ۲۰٪ | فقط اثرهای بزرگ دیده میشدند |
| «کم توان» | بیش از ۲۰٪ | آزمون از ابتدا توان نداشت؛ خنثی چیزی دربارهٔ اقدام نمیگوید |
پس آزمون «کم توان» با حکم «خنثی» یعنی «نمیدانیم»، نه «اثری نداشت». راه درست کردنش یکی از اینهاست: پنجرهٔ اندازهگیری بلندتر، دورهٔ پیشین بلندتر، یا سنجهای با حجم روزانهٔ بیشتر (مثلا add_to_cart بهجای purchase وقتی سفارشها کماند).
کارتهای اثر#
- «لیفت افزایشی» — مجموع تفاوت واقعیت و ضدواقعیت در کل پنجره، با درصد نسبی و «بازه اطمینان ۹۵٪».
- «میانگین روزانه (همه)» و «میانگین روزانه (ارگانیک)» — تصویر کانیبالیزیشن؛ اگر کل بالا رفته ولی ارگانیک به همان اندازه پایین آمده، اقدام عمدتا تقاضای موجود را جابهجا کرده.
- «درآمد افزایشی» — برای سنجه درآمد مستقیم مدل سازی میشود. برای سنجه تبدیل، با عنوان «درآمد برآوردی (تعداد خرید × میانگین ارزش سفارش)» میآید: لیفت ضرب در میانگین ارزش سفارش در دوره پیش از آزمایش.
- «هزینه تبلیغات (پنجره)»، «ROAS افزایشی» و «هزینه به ازای جذب» — همه بر پایهٔ هزینهٔ همان کانال و کمپینی که در تعریف آزمون انتخاب کردهاید. اگر نقش شما اجازهٔ دیدن هزینه را نداشته باشد، این سه کارت نمایش داده نمیشوند.
نمودار و جدول روزانه#
در «اثر افزایشی در طول زمان»، خط ممتد «مشاهده شده» است، خط چین «ضدواقعیت»، ناحیهٔ سایهدار بازهٔ پیشبینی ۹۵٪ و خط نازک «ارگانیک». نشانگر عمودی روی تاریخ اقدام است. جایی که خط ممتد بالای نوار سایهدار برود، لیفت مثبت واقعی است؛ داخل نوار یعنی همان چیزی که بههرحال انتظار میرفت.
با تیک «فقط نمایش پس از اقدام» میتوانید دورهٔ پیشین را کنار بگذارید و روی پنجرهٔ اندازهگیری متمرکز شوید. جدول «لیفت افزایشی روزانه (دوره پسین)» همان را روزبهروز عددی میدهد، و «دادههای پیشرفته» چهار ردیف خام پیش و پس را برای همه و برای ارگانیک کنار هم میگذارد.
چیزی که لیفت نمیتواند بگوید#
ضدواقعیت، روند پیش از اقدام را ادامه میدهد. هر اتفاق دیگری که دقیقا همزمان با اقدام شما بیفتد، به حساب اقدام نوشته میشود: تغییر قیمت، کمپین کانال دیگری، یک خبر رسانهای، خرابی سایت.
سه محافظ در کار است — کنترل تقاضای ارگانیک، رویدادهای تقویم فصلی، و حکم خنثی بهصورت پیشفرض — ولی هیچکدام جای انضباط شما را نمیگیرد:
- هر بار یک چیز را عوض کنید و تاریخش را دقیق ثبت کنید.
- برای اقدامهای همزمان روی چند کانال، آزمونهای جدا با کانالهای جدا بسازید.
- فرض کنترل این است که اقدام روی خودِ ارگانیک اثری ندارد؛ اگر کمپین شما آشکارا جستجوی برند را بالا میبرد، این فرض کمی سست میشود و بهتر است کنترل را خاموش کنید و هر دو حالت را ببینید.
آزمونی که تمام شده و «انجام شده» است را میتوانید «ویرایش» کنید (ذخیره، دوباره اجرایش میکند)، «تکثیر» کنید تا همان تعریف برای اقدام بعدی آماده شود، «اجرای مجدد» بزنید وقتی دادهای دیر رسیده، یا با منوی «خروجی» بهصورت «گزارش PDF»، «CSV (داده)» یا «PNG (نمودار)» بیرون بدهید.
یک تست لیفت معنادار روی یک کانال مشخص، بهترین ورودی برای کالیبراسیون مدل مارکتینگ میکس است. عدد ROI و خطای استاندارد آن را در کارت «آزمایش های کالیبراسیون (تثبیت مدل با تست های لیفت)» وارد کنید تا اجرای بعدی مدل، سنجش علی شما را به تاریخچهٔ مشاهدهای گره بزند.
پرسشهای پرتکرار#
حکم «خنثی» یعنی آزمون شکست خورده؟
نه. خنثی یعنی تغییری که دیدید درون بازه اطمینان ضدواقعیت جا میشود، پس نمیشود آن را به اقدام نسبت داد. این یک نتیجهٔ واقعی است و همان چیزی است که جلوی خرجکردن بر پایهٔ نوسان تصادفی را میگیرد. کارت «قابلیت تشخیص» میگوید آزمون اصلا توان دیدن چه اندازه اثری را داشته است.
چرا آزمون من «زمان بندی شده» مانده و اجرا نمیشود؟
چون دورهٔ اندازهگیری هنوز کامل نشده. آزمون خودکار وقتی اجرا میشود که تمام روزهای دوره گذشته باشد، بهعلاوهٔ ۲ روز مهلت برای رسیدن تبدیلهای دیررس. سنجیدن یک پنجرهٔ نیمهتمام، لیفت منفی جعلی میسازد.
دورهٔ پیشین را چقدر بگذارم؟
پیشفرض فرم ۵۶ روز است و راهنمای همان فیلد دستکم ۴۲ روز را توصیه میکند. زیر ۱۴ روز اصلا قابل برازش نیست و آزمون با پیام کمبود داده بسته میشود. تاریخچهٔ بلندتر، ضدواقعیت دقیقتر و بازهٔ باریکتری میدهد.
روش تحلیل کالیبرهشده با آزمون پلاسیبو چه چیزی را تغییر میدهد؟
بازه اطمینان و p-value دیگر از برآورد خود مدل از خطایش نمیآیند؛ از دهها آزمون ساختگی روی تاریخهایی از یک سال گذشته خودتان میآیند که در آنها هیچ تغییری نداده بودید. پس «معنادار» روی دادههای شما واقعا همان معنا را دارد. این روش حدود یک سال داده میخواهد؛ با داده کمتر، نتیجه «مبتنی بر مدل» برچسب میخورد.
تفاوت لیفت با مدل مارکتینگ میکس چیست؟
لیفت یک اقدام مشخص را در یک بازهٔ کوتاه میسنجد و با حدود دو ماه داده کار میکند؛ مدل مارکتینگ میکس کل سبد کانالها را در حدود دو سال میسنجد. دو ابزار مکملاند و نتیجهٔ یک تست لیفت را میتوانید بهعنوان کالیبراسیون به مدل مارکتینگ میکس بدهید.
ممنون — بازخورد شما به بهتر شدن مستندات کمک میکند.